程序员羊肉-腾讯暑期一面部分答案(操作系统和数据库)
面试问题#
- 描述一个线程从创建开始的完整生命周期
- cpu切换线程的整个过程是怎么样的
- 切换进程比切换线程多了什么开销
- 手撕并发安全的count计数
- 读操作需要加锁吗,为什么
- 怎么理解工作内存和内存屏障
- 说一下 update t set c = c + 1 where id = 10 这个sql执行的过程
- 到了innodb的存储引擎层,这个sql是怎么处理的
- 能具体说说这个update更新操作是怎样的更新方式吗
- 它是怎么最终把数据写到磁盘里的
- 你说是异步到磁盘里的,怎么理解这个异步
- 了解过undolog和redolog吗
- buffer pool了解过吗
- update这个语句会加什么锁
- 数据更新是发生在buffer pool还是在磁盘里的
- 你说是发生在buffer pool里再异步刷新到磁盘,它为什么要这样设计呢,为什么要做两阶段的提交
- 除了减少IO还有什么别的原因吗?
- redolog有什么好处呢
参考答案(AI 生成)#
以下答案由 AI 生成,仅供面试复盘参考。
1. 描述一个线程从创建开始的完整生命周期#
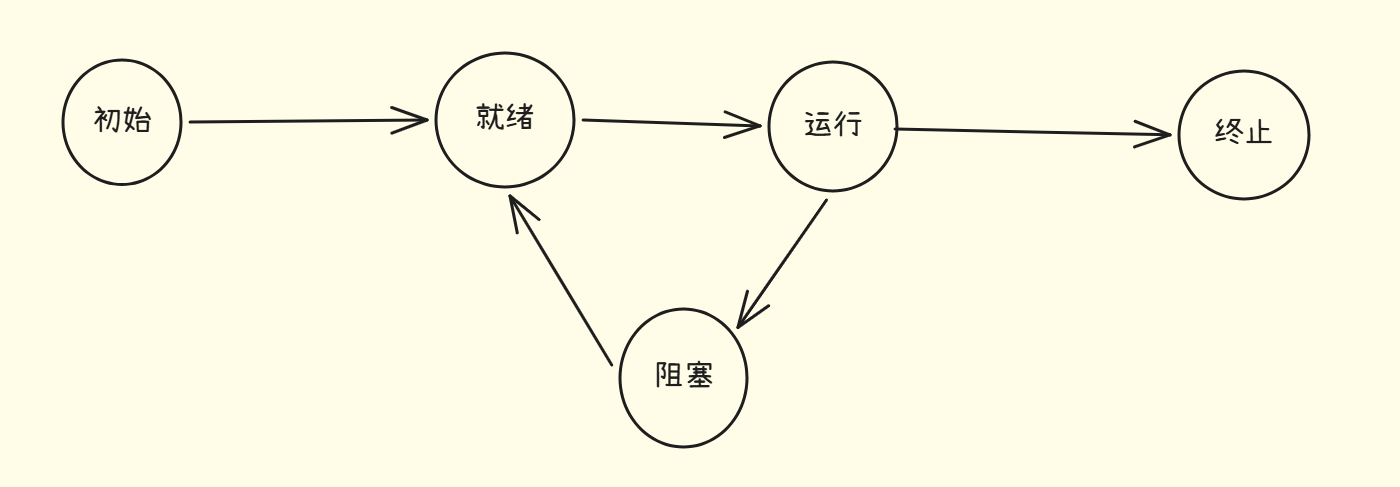
线程共有5个状态:新建(init), 就绪(runnable), 运行(running), 阻塞(blocked), 终止(dead)
2. cpu切换线程的整个过程是怎么样的#
总体流程:用户态->内核态->用户态 详细如下
- cpu提升硬件权限等级,切换内核栈
- cpu硬件将旧线程的SS, RSP, CS, RIP, RFALGS等压入该线程的内核栈中。
- 随后cpu跳转到处理中断程序的入口,内核中的汇编代码会将其他通用寄存器也压入内核栈中(这里使用汇编不用c是因为我们不能确定编译器会如何使用寄存器,我们要保证寄存器中的数据完好无损,所以使用汇编直接操作)
- 处理完中断或系统调用的逻辑后,如果当前线程需要让出cpu,会通过调度器根据调度公平算法从就绪队列中选出一个线程
- 然后检查这两个线程是否属于同一个进程,这决定了是否切换页表和刷新TLB。接着切换新线程的内核栈,然后保存和恢复一些基于线程的硬件状态
- 接下来汇编会从内核栈中弹出之前保存的新线程的通用寄存器
- 最后内核执行返回指令。cpu自动从内核栈中弹出之前保存的现场(SS, RSP, CS, RIP, RFALGS等),cpu特权等级恢复为用户态。
3. 切换进程比切换线程多了什么开销#
这里问的应该是不同进程的线程和同一进程的线程比切换多了什么开销。 多了切换页表的开销
4. 手撕并发安全的count计数#
- 互斥锁
import "sync"

type counter struct {
    mu sync.Mutex
    cnt int
}

func (c *counter) Add(num int) {
    c.mu.Lock()
    defer c.mu.Unlock()
    c.cnt += num
}

func (c *counter) Get() int{
    c.mu.Lock()
    defer c.mu.Unlock()
    return c.cnt
}- 原子指令
import "sync/atomic"

type counter struct {
    cnt int64
}

func (c *counter) Add(num int64) {
    atomic.AddInt64(&c.cnt, num)
}

func (c *counter) Get() int64{
    return atomic.LoadInt64(&c.cnt)
}- 读写锁
import (
    "sync"
)

type counter struct {
    cnt int64
    rw sync.RWMutex
}

func (c *counter) Add(num int64) {
    c.rw.Lock()
    defer c.rw.Unlock()
    c.cnt += num
}

func (c *counter) Get() int64{
    c.rw.RLock()
    defer c.rw.RUnlock()
    return c.cnt
}
5. 读操作需要加锁吗,为什么#
需要。从如下方面考虑
硬件可见性#
写入端: 每个CPU核心都有自己的L1/L2缓存,当一个写入数据时,不会直接写入缓存行,而是先写入Store buffer(CPU和L1缓存之间的缓存),然后向其他核心发送失效信号。由于数据没有写入缓存行,其他核心缓存行中的数据是修改前的数据 读取端: 而读取端为了不中断当前的流水线,会先把这个信号存入一个失效队列,然后回复“已收到”,此时Cache虽然逻辑上已失效,但还没来得及真正擦除,如果此时进行读取,CPU 会依然从自己的 Cache 里读到旧数据。 而加锁能触发硬件内存屏障,确保Store buffer中数据进入缓存行或使其他核心的缓存行中的数据失效
编译器优化#
编译器可能认为cnt后续不变,将cnt中的值缓存在一个寄存器中,即使CPU缓存更新了也不会去检查CPU缓存,从而导致读取的值一直不变。 (一种理论上的可能,但作者在Go1.25.5中没能在并发counter中观察到这个现象) 验证过程:考虑如下代码
package main

import (
    "fmt"
    "time"
)

type counter struct {
    cnt int64
}

func main() {
    c := &counter{cnt: 0}

    // 写入协程
    go func() {
        time.Sleep(100 * time.Millisecond) // 确保读取端已经进入死循环
        c.cnt = 1
        fmt.Println("写入端:已修改 cnt 为 1")
    }()

    // 读取协程
    go func() {
        for c.cnt == 0 {
            // 空循环
        }
        fmt.Println("读取端:检测到 cnt 改变")
    }()
    time.Sleep(2 * time.Second)
    fmt.Println("主程序结束")

}
查看 “for c.cnt == 0”的汇编
    0x0012 00018 (main.go:25) CMPQ  (DX), $0

    0x0016 00022 (main.go:25) JEQ 18
可以看到每次都从DX指向的内存地址中重新读取c.cnt的值,没有选择将变量长期缓存在寄存器里
读取操作的原子性#
读取操作可能不是原子的,例如在32位的机器上读取一个int64不是一个原子操作
6. 怎么理解工作内存和内存屏障#
工作内存:Go中没有类似于JMM中工作内存的概念,但并不意味着Go在多协程并发下不会遇到指令重排和可见性的问题。Go解决这些问题的底层依然依赖于内存屏障。不过Go出于简洁的考虑,封装了mutex, channel,atomic等更高级的并发原语,帮助我们屏蔽了底层的复杂性。 内存屏障:一组CPU指令,可以阻止指令重排和解决可见性问题。指令重排通过规定屏障前的指令先执行,屏障后的指令后执行解决。可见性问题通过强制将 Store Buffer中的修改同步到L1缓存和强制处理失效队列中的数据,确保其他核心及时读到有效的新数据。
7. 说一下 update t set c = c + 1 where id = 10 这个sql执行的过程#
分为两个层面的处理:server层和存储引擎层
Server 层负责建立连接、分析和执行 SQL,主要包括主要包括连接器,查询缓存、解析器、预处理器、优化器、执行器等
- 首先客户端会和MySQL服务器建立连接,连接器会验证账号密码和获取该用户的权限,此后的操作都是基于此权限进行的
- MySQL 服务收到 SQL 语句后,就会解析出 SQL 语句的第一个字段,看看是什么类型的语句.如果是select,MySQL会查找缓存数据,看看这条命令有没有被执行,如果缓存命中了直接返回结果。(但由于缓存命中率较低,该功能在MySQL8.0中废除了)
- 正式执行MySQL语句前,解析器会对语句进行词法分析和语法分析
- 预处理会检查表或字段是否存在,检查用户权限等
- 优化器会选择执行该语句最优的方案
- 确定优化方案后执行器就开始执行语句了
下面就进入存储引擎层的处理了,见下
8. 到了innodb的存储引擎层,这个sql是怎么处理的#
- 存储引擎会根据B+树找到id=10所在的数据页。如果该数据页在buffer pool中,存储引擎会将id=10的记录返回给执行器。如果不在则要先将数据页从磁盘加载到buffer pool再返回
- 执行器会完成c + 1的计算,得到一行新数据,然后调用存储引擎的api写入这条数据
- 在真正修改buffer pool前,需要将旧的数据写入undo log中
- 然后进行两阶段提交:prepare阶段:将修改记录写入redo log,同时将 redo log 对应的事务状态设置为 prepare,然后将redo log写入磁盘。commit阶段:执行器将这次修改的逻辑记录写入到binlog(STATEMENT格式),然后将 binlog 持久化到磁盘。接着将redo log的状态设置为commit,此状态会写入操作系统的文件缓存,但不需要持久化
9. 能具体说说这个update更新操作是怎样的更新方式吗#
就地更新。c是一个int, 更新前后占用字节大小不变,在原有的位置直接覆盖新的值即可
10. 它是怎么最终把数据写到磁盘里的#
后台有一组线程专门负责将buffer pool中的脏页写入磁盘 触发条件如下:
- redo log满了
- buffer pool空间不足,需要淘汰一部分数据页
- MySQL认为空闲时,会定期刷入适量脏页
- MySQL正常关闭时
值得注意的是脏页不会直接写入到数据文件(.ibd)中,这会带来部分写失效的问题(MySQL中页的大小为16KB, 操作系统一般是4KB, 需要写入四次。如果中途写入宕机了,数据页就损坏了,无法恢复),为了解决这个问题,数据会先写入一个叫Doublewrite Buffer的内存区域,然后将Doublewrite Buffer 落盘,落盘成功后再将脏页写入数据文件。这相当于提供了一个副本,写入数据文件发生了宕机时可以靠这个副本恢复
11. 你说是异步到磁盘里的,怎么理解这个异步#
这个异步指修改内存中的脏页和将脏页写入磁盘这两个行为是异步的
12. 了解过undolog和redolog吗#
undo log(回滚日志):每当InnoDB引擎对一条记录进行操作(修改、删除、新增)时,要把回滚时需要的信息都记录到undo log里。用于事务的回滚和MVCC的实现 redo log: redo log是一个物理日志,记录了XXX表空间YYY数据ZZZ页偏移量做了AAA更新,用于事务崩溃恢复,保证事务的持久性
13. buffer pool了解过吗#
MySQL 的数据是存储在磁盘里的,但是也不能每次都从磁盘里面读取数据。为了提高性能,innodb设计了buffer pool
14. update这个语句会加什么锁#
id是主键索引,加X型记录锁
15. 数据更新是发生在buffer pool还是在磁盘里的#
在buffer pool更新后再异步刷新到磁盘
16. 你说是发生在buffer pool里再异步刷新到磁盘,它为什么要这样设计呢,为什么要做两阶段的提交#
为什么要这样设计:直接写入到磁盘中性能极差,会产生大量的随机IO和不必要的IO。这样设计有如下好处:
- 可以合并写入,减少IO次数
- 可以一次刷入多个脏页,提升吞吐量
- 可选择刷入脏页的时机,避免在业务高峰时刷入
- 虽然数据页的分布是随机的,但后台线程可以对刷脏请求进行排序,让磁盘头更好地移动
为什么要做两阶段的提交: 防止出现"半成功",造成主从不一致的情况
17. 除了减少IO还有什么别的原因吗?#
见上
18. redolog有什么好处呢#
- 实现了crash-safe,保证了数据库持久性
- 实现了WAL,保证了异步刷脏的可靠性,极大提高了写入性能